数据建模指南
表结构设计将极大影响写入和查询性能。 在写入数据之前,你需要了解业务中涉及到的数据类型、数据规模以及常用查询, 并根据这些数据特征进行数据建模。
设计一张表时,主要需要做出以下几个决定:
- 哪些列组成主键(决定数据排序和时间序列身份);
- 表是 append-only 还是需要去重,以及使用哪种合并模式;
- 哪些列需要索引;
- 如何在表之间组织数据(一张宽表还是多张表),以及如何通过分区扩展规模。
本文先说明 GreptimeDB 如何存储和读取数据,然后依次介绍这些设计决策。
基本概念
在阅读本文档之前,请先阅读 GreptimeDB 数据模型文档。
基数
基数(Cardinality):指数据集中唯一值的数量。可以分为"高基数"和"低基数":
- 低基数(Low Cardinality):低基数列通常具有固定值。
唯一值的总数通常不超过1万个。
例如,
namespace、cluster、http_method通常是低基数的。 - 高基数(High Cardinality):高基数列包含大量的唯一值。
例如,
trace_id、span_id、user_id、uri、ip、uuid、request_id、表的自增 ID,时间戳通常是高基数的。
语义类型
在 GreptimeDB 中,列被分为三种语义类型:Tag、Field 和 Timestamp。
时间戳通常表示数据采样的时间或日志/事件发生的时间。
GreptimeDB 使用 TIME INDEX 约束来标识 Timestamp 列。
因此,Timestamp 列也被称为 TIME INDEX 列。
如果你有多个时间戳数据类型的列,你只能将其中一个定义为 TIME INDEX,其他的定义为 Field 列。
在 GreptimeDB 中,Tag 列是可选的。
GreptimeDB 复用 PRIMARY KEY 约束来定义 Tag 列;它们共同标识一条时间序列,并定义数据在存储中的排序方式(见 GreptimeDB 如何存储和读取数据)。
Tag 列的主要用途包括:
- 定义数据在存储中的排序方式,从而提高相同 tag 数据的局部性。如果没有定义 tag 列,GreptimeDB 按时间戳对行进行排序。
- 标识唯一的时间序列,使 GreptimeDB 能在表不是 append-only 时,在同一时间序列(主键)下对行进行去重。
- 便于从使用 label 或 tag 的其他时序数据库迁移。
GreptimeDB 如何存储和读取数据
了解 GreptimeDB 如何存储数据和执行查询,有助于理解本文后续的设计建议。 后续章节会多次引用这里介绍的概念。 关于引擎层面的细节,包括磁盘上的 SST 文件格式和完整的扫描裁剪流程,请参考存储引擎文档中的 SST 文件中的数据布局和扫描裁剪。
数据按主键和时间排序
GreptimeDB 按 (primary key, timestamp) 对行进行排序。
具有相同主键的行组成一条时间序列,并按时间顺序相邻存储。
这种局部性让扫描单条时间序列的成本更低,也有利于压缩。
关于行在磁盘上如何布局的具体示例,请参考 SST 文件中的数据布局。
扫描会分阶段裁剪数据
GreptimeDB 将数据存储在不可变文件(SST 文件)中。 每个文件会被切分为 row group,每个 row group 都保存每列的最小值、最大值等统计信息。 执行查询时,GreptimeDB 会按从粗到细的阶段避免读取不可能匹配的数据:
- 时间范围:跳过时间范围与查询时间范围不相交的整个文件(以及内存缓冲区)。对于时序数据,这通常是成本最低且效果最好的步骤。
- Row group min/max 统计信息:在文件内部,跳过统计信息可以证明没有任何行匹配过滤条件的 row group。
- 索引:如果过滤列有索引,使用索引进一步缩小到特定 row group 或行。
- 读取并过滤:读取剩余数据并应用精确过滤条件。
以查询 PRIMARY KEY (host, region) 的 host_metrics 表为例:
SELECT ts, cpu
FROM host_metrics
WHERE host = 'host-a'
  AND region = 'us-east'
  AND ts >= '2024-01-01 10:00:00'
  AND ts < '2024-01-01 11:00:00'
  AND cpu > 0.7;
时间范围会移除数据不在这一小时时间窗口内的文件。
主键排序会把所有 host-a / us-east 的行放在一起,因此扫描只需要读取每个剩余文件中的一小段连续数据,而不是整个文件。
首个主键列上的 row group 统计信息尤其有效。由于行按主键排序,主键的第一列(host)在每个 row group 中通常具有紧凑且不重叠的范围:
| Row group | host (min..max) |
|---|---|
| 0 | host-a .. host-b |
| 1 | host-c .. host-f |
过滤条件 host = 'host-a' 只可能匹配 row group 0,因此 row group 1 无需读取即可跳过。
合理选择并排序主键,可以让首个主键列成为有效的粗粒度裁剪键,而无需额外索引。
不过这种裁剪是粗粒度的:GreptimeDB 没有维护主键的全局索引,因此不能直接跳到某个主键对应的行。它只能通过 row group 的 min/max 值跳过数据,这对首个主键列效果较好,但对主键中靠后的列或高基数列上的点查帮助有限,这正是索引适合解决的问题。
Field 列上的统计信息也有帮助:如果某个 row group 的 cpu 最大值是 0.6,则可以在 cpu > 0.7 的查询中跳过它。
索引用于处理排序和统计信息无法高效处理的选择性过滤条件。 例如,列上的索引可以让扫描在解码数据列之前定位到匹配的 row group 或行。见索引。
去重发生在扫描期间
GreptimeDB 使用 LSM-tree 存储引擎:它不会就地覆盖数据,因此同一行的多个版本可能同时存在于多个文件中。
对于不是 append-only 的表,扫描会即时合并和去重具有相同 (primary key, timestamp) 的行,只保留最新版本(见数据更新和合并)。
Append-only 表会跳过这项工作。 它们不需要去重,并且当查询不要求有序输出时,可以按任意顺序扫描,因此速度更快。
要点
- 按时间范围和主键前导列过滤,是提升查询性能成本最低的方式。
- 索引适合加速排序无法覆盖的选择性过滤条件。
- 去重(非 append-only 表)会在查询时增加额外工作。
主键
主键是影响表结构设计最大的决策:它定义了数据在磁盘上的排序方式,并标识用于去重的时间序列。 本节帮助你判断是否需要设置主键,以及应该使用哪些列。
主键是可选的
错误的主键或索引可能会显著降低性能。 通常,你可以创建一个没有主键的仅追加表,因为对于许多场景来说,按时间戳排序数据已经有不错的性能了。 这也可以作为性能基准。
CREATE TABLE http_logs (
  access_time TIMESTAMP TIME INDEX,
  application STRING,
  remote_addr STRING,
  http_status STRING,
  http_method STRING,
  http_refer STRING,
  user_agent STRING,
  request_id STRING,
  request STRING,
) with ('append_mode'='true');
http_logs 表是存储 HTTP 服务器日志的示例。
'append_mode'='true'选项将表创建为仅追加表。 这确保一个日志不会覆盖另一个具有相同时间戳的日志。- 该表按时间对日志进行排序,因此按时间搜索日志效率很高。
主键设计
当有适合的列且满足以下条件之一时,可以使用主键:
- 大多数查询可以从排序中受益。
- 你需要通过主键和时间索引对行进行去重(包括删除)。
例如,如果你总是只查询特定应用程序的日志,可以将 application 列设为主键(tag)。
SELECT request FROM http_logs WHERE application = 'greptimedb' AND access_time > now() - '5 minute'::INTERVAL;
应用程序的数量通常是有限的。表 http_logs_v2 使用 application 作为主键。
它按应用程序对日志进行排序,因此查询同一应用程序下的日志速度更快,因为它只需要扫描少量行。设置 tag 还能减少磁盘空间,因为它提高了数据的局部性,对压缩更友好。
CREATE TABLE http_logs_v2 (
  access_time TIMESTAMP TIME INDEX,
  application STRING,
  remote_addr STRING,
  http_status STRING,
  http_method STRING,
  http_refer STRING,
  user_agent STRING,
  request_id STRING,
  request STRING,
  PRIMARY KEY(application),
) with ('append_mode'='true');
过长的主键将对插入性能产生负面影响并增加内存占用。主键最好不超过 5 个列。
你可以将 trace_id、span_id 或 user_id 等高基数列放入主键,但这通常不是过滤它们的最佳方式。
将高基数列加入主键有成本,但收益有限:
- 它会让主键更长,从而降低写入速度并增加内存使用。
- 在去重表上,按高基数主键去重成本很高。如果可以容忍重复,应该使用 append-only 表。
- 与跳数索引不同,它并不总能显著提升查询速度。
跳数索引可以用更低的开销处理同类过滤条件,因此通常是更好的默认选择。只有在确实需要按某个高基数列排序或去重时,才建议把它加入主键。由于最佳布局取决于你的数据和查询模式,建议在自己的数据集上进行基准测试后再决定。
选取 tag 列的建议:
- 在
WHERE/GROUP BY/ORDER BY中频繁出现的低基数列。 这些列通常很少变化。 例如,namespace、cluster或 AWSregion。 - 无需将所有低基数列设为 tag,因为这可能影响写入和查询性能。
- 通常对 tag 使用短字符串和整数,避免
FLOAT、DOUBLE、TIMESTAMP。 - 对于
trace_id、span_id和user_id等高基数列,优先使用跳数索引;只有在需要按它们排序或去重时,才将其加入主键。 - 主键列应优先把最常过滤、选择性最高的列放在前面。前导列最能受益于排序和 row group 裁剪(见 GreptimeDB 如何存储和读取数据)。
去重和 Append-Only
接下来,需要决定表如何处理具有相同主键和时间戳的行:
- Append-only(
append_mode = 'true'):保留每一行,不执行去重或删除。这是最快的选项。 - 去重表(默认):每个
(primary key, timestamp)只保留一行,并通过合并模式(last_row或last_non_null)控制更新如何合并。
当不需要更新或删除时(例如日志),请选择 append-only。
否则使用默认的去重模式,即保持 append_mode 为 false,并按主键和时间戳删除重复行。
由于去重按 (primary key, timestamp) 对行分组,主键决定了什么算作重复。
请确保主键能唯一标识一条时间序列,避免把你想保留为独立数据的行合并掉(见主键)。
例如,system_metrics 表按 host 和 ts 对行去重:
CREATE TABLE IF NOT EXISTS system_metrics (
  host STRING,
  cpu_util DOUBLE,
  memory_util DOUBLE,
  disk_util DOUBLE,
  ts TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
  PRIMARY KEY(host),
  TIME INDEX(ts)
);
数据更新和合并
GreptimeDB 支持两种不同的去重策略:last_row 和 last_non_null。
你可以通过 merge_mode 表选项来指定策略。
merge_mode 只对去重表生效。Append-only 表不会合并行,因此通常不需要设置 merge_mode。
GreptimeDB 使用基于 LSM-Tree 的存储引擎,
不会就地覆盖旧数据,而是允许多个版本的数据共存。
这些版本在查询时再合并。
默认的合并行为是 last_row,意味着只保留最近插入的行。
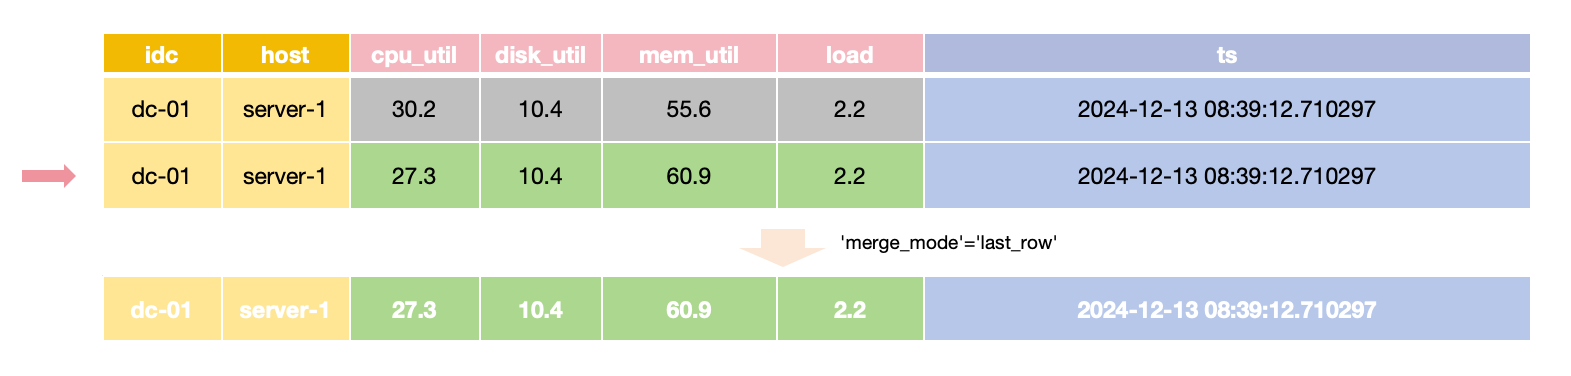
在 last_row 合并模式下,
对于相同主键和时间值,只返回最新的行,
所以更新一行时需要提供所有 field 的值。
对于只需要更新特定 field 值而其他 field 保持不变的场景,
可以将 merge_mode 选项设为 last_non_null。
该模式在查询时会选取每个字段的最新的非空值,
这样可以在更新时只提供需要更改的 field 的值。
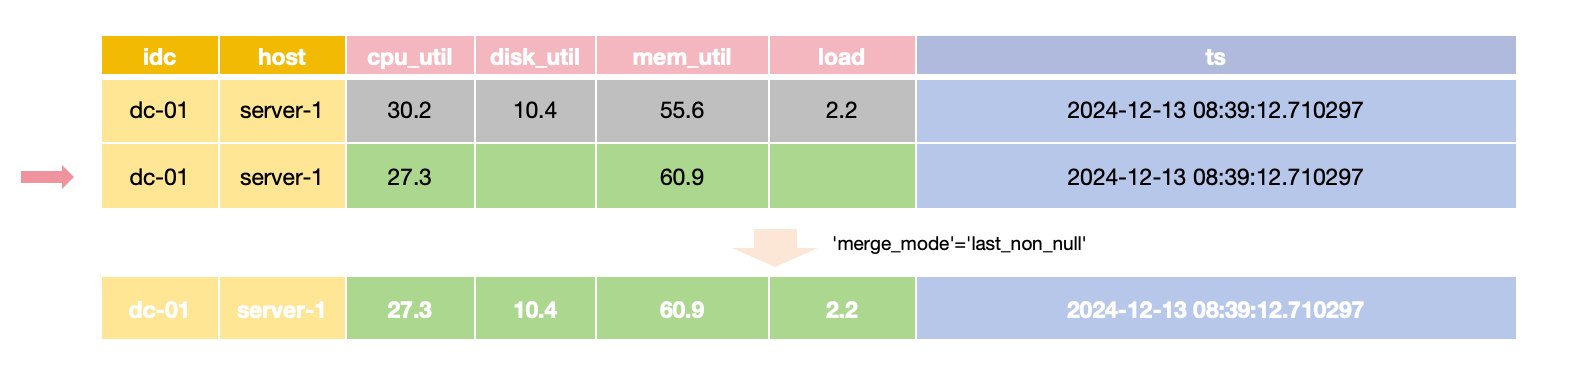
通过 InfluxDB line protocol 自动创建的表默认使用 last_non_null,以便与 InfluxDB 的更新行为保持一致;你可以通过 influxdb.default_merge_mode 选项配置该行为。
last_row 合并模式不需要检查每个单独的字段值,因此通常比 last_non_null 模式更快。
去重和合并只发生在单个分区内。 如果你按不属于主键的列对去重表(任何非 append-only 表)进行分区,具有相同主键的行可能会被分散到不同分区中,它们之间就不会相互去重。
为了保持去重正确性,只应使用主键列作为分区列,确保具有相同主键的行始终进入同一个分区。 GreptimeDB 不会强制检查这一点,这是你的责任。 见分布式表。
何时使用 append-only 表
如果不需要以下功能,可以使用 append-only 表:
- 去重
- 删除
GreptimeDB 通过去重功能实现 DELETE,因此 append-only 表目前不支持删除。
去重需要更多的计算并限制了写入和查询的并行性,所以使用 append-only 表通常具有更好的性能。
索引
确定主键和表模式之后,可以添加索引来加速特定过滤条件。 索引是可选的;只有当某个过滤条件很常见且性能还不够好时,才需要添加索引,并且应根据列的特点选择索引类型(见何时使用索引中的对比)。
主键和索引是互补关系,而不是二选一:
- 主键为每张表提供一种物理排序。它有助于范围扫描和数据局部性,也是去重和删除所必需的。
- 索引是辅助结构,可以添加到任意列上,无论该列是 tag 还是 field。它用于加速排序本身无法覆盖的选择性过滤条件(例如高基数列上的点查)。
一个查询可以同时使用主键和索引。例如,当 application 是主键且 request_id 上有跳数索引时,GreptimeDB 会先用时间范围和 application 排序读取较小的数据范围,再用 request_id 上的索引定位匹配行。
倒排索引
GreptimeDB 支持倒排索引,可以加速对低基数列的过滤。
创建表时,可以使用 INVERTED INDEX 子句指定倒排索引列。
例如,http_logs_v3 为 http_method 列添加了倒排索引。
CREATE TABLE http_logs_v3 (
  access_time TIMESTAMP TIME INDEX,
  application STRING,
  remote_addr STRING,
  http_status STRING,
  http_method STRING INVERTED INDEX,
  http_refer STRING,
  user_agent STRING,
  request_id STRING,
  request STRING,
  PRIMARY KEY(application),
) with ('append_mode'='true');
以下查询可以使用 http_method 列上的倒排索引。
SELECT request FROM http_logs_v3 WHERE application = 'greptimedb' AND http_method = 'GET' AND access_time > now() - '5 minute'::INTERVAL;
倒排索引支持以下运算符:
=<<=>>=INBETWEEN~
跳数索引
对于 trace_id、request_id 等高基数列,跳数索引通常比较合适。
这种方法的存储开销更低,资源使用量更少,特别是在内存和磁盘消耗方面。
示例:
CREATE TABLE http_logs_v4 (
  access_time TIMESTAMP TIME INDEX,
  application STRING,
  remote_addr STRING,
  http_status STRING,
  http_method STRING INVERTED INDEX,
  http_refer STRING,
  user_agent STRING,
  request_id STRING SKIPPING INDEX,
  request STRING,
  PRIMARY KEY(application),
) with ('append_mode'='true');
以下查询可以使用跳数索引过滤 request_id 列。
SELECT request FROM http_logs_v4 WHERE application = 'greptimedb' AND request_id = '25b6f398-41cf-4965-aa19-e1c63a88a7a9' AND access_time > now() - '5 minute'::INTERVAL;
然而,请注意跳数索引的查询功能通常不如倒排索引丰富。
跳数索引无法处理复杂的过滤条件,在低基数列上可能有较低的过滤性能。它适用于等值谓词,以及能归约为集合成员判断的谓词,例如 IN 和一组由 OR 连接的等值条件;其他运算符不会走该索引。
全文索引
对于需要分词和按术语搜索的非结构化日志消息,GreptimeDB 提供了全文索引。
例如,raw_logs 表在 message 字段中存储非结构化日志。
CREATE TABLE IF NOT EXISTS `raw_logs` (
  message STRING NULL FULLTEXT INDEX WITH(analyzer = 'English', case_sensitive = 'false'),
  ts TIMESTAMP(9) NOT NULL,
  TIME INDEX (ts),
) with ('append_mode'='true');
message 字段使用 FULLTEXT INDEX 选项进行全文索引。
更多信息请参见fulltext 列选项。
存储和查询结构化日志通常比带有全文索引的非结构化日志性能更好。 建议使用 Pipeline 将日志转换为结构化日志。
何时使用索引
GreptimeDB 中的索引十分灵活。 你可以为任何列创建索引,无论该列是 tag 还是 field。 为 time index 列创建额外索引没有意义。 另外,你一般不需要为所有列创建索引。 因为维护索引可能引入额外成本并阻塞 ingestion。 不良的索引可能会占用过多磁盘空间并使查询变慢。
你可以用没有额外索引的表作为 baseline。 如果查询性能已经可接受,就无需为表创建索引。 在以下情况可以为列创建索引:
- 该列在过滤条件中频繁出现。
- 没有索引的情况下过滤该列不够快。
- 该列有合适的索引类型。
下表列出了所有索引类型的适用场景。
| 倒排索引 | 全文索引 | 跳数索引 | |
|---|---|---|---|
| 适用场景 | - 过滤低基数列 | - 文本内容搜索 | - 精确过滤高基数列 |
| 创建方法 | - 使用 INVERTED INDEX 指定 | - 在列选项中使用 FULLTEXT INDEX 指定 | - 在列选项中使用 SKIPPING INDEX 指定 |
宽表 vs. 多表
确定单张表的 schema 后,需要决定如何在表之间组织数据:把同时采集的列放入一张宽表,把逻辑上不同的数据拆成多张表,并且只有在单个节点无法承载某张表时才对它进行分区。
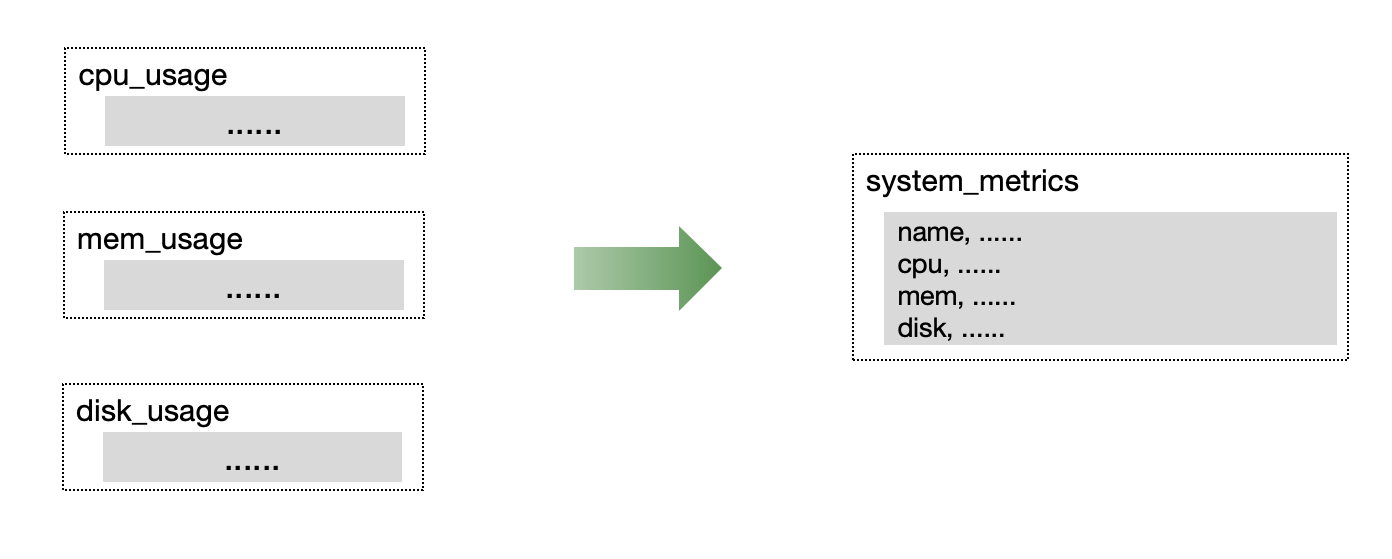
在监控或 IoT 场景中,通常同时收集多个指标。 我们建议将同时收集的指标放在单个表中,以提高读写吞吐量和数据压缩效率。
Prometheus 指标和 Metric Engine
对于 Prometheus 风格的指标,GreptimeDB 依赖 Metric Engine。 如果通过 Prometheus remote write API 写入数据,GreptimeDB 会自动将其路由到 metric engine:表会自动创建,无需额外配置。
在底层,metric engine 通过把许多小的指标表存储在共享的物理宽表上,高效处理 Prometheus 的单值模型。 每个指标仍然是独立的逻辑表,而共享存储可以提高读写吞吐量和压缩效率。
当扩展到集群时,需要特别关注分区。
默认情况下,metric engine 使用一张只有一个分区的物理表,这足以满足大多数工作负载。
但在集群中,这意味着所有写入都由单个 datanode 处理。
为了将负载分散到多个节点,你可以基于合适的 label(例如 namespace)创建自己的分区物理表。
示例见 GreptimeDB cluster with metric engine。
多表 vs. 多分区
拆成多张表和对单张表分区解决的是不同问题,也可以组合使用:
- 当数据在逻辑上不同时,使用多张表:例如 schema 不同、列集合不同,或保留时间(TTL)要求不同。独立的表也可以拥有各自的主键、索引和合并模式,而一张宽表的所有列必须共享同一套配置。多表能保持 schema 清晰,并允许你独立调优和设置保留策略。代价是表数量更多:每张表都维护自己的文件,因此把数据拆成许多小表会产生许多小文件。
- 当单张表太大、单个节点无法承载时,使用多个分区(分布式表)。分区会把同一张表的行拆分到多个节点上,以实现水平扩展,同时仍然保留为一张表;相比许多独立小表,它能分散负载而不会产生同样多的小文件。见分布式表。
简而言之:为了逻辑隔离拆成多张表,为了扩展规模拆成多个分区。
分布式表
GreptimeDB 支持对数据表进行分区,以分散读写热点并实现水平扩展。 本节延续上面的数据布局讨论,帮助你判断是否需要对表分区、创建多少分区,以及选择哪些分区列。
关于分布式表的两个误解
GreptimeDB 在存储层自动基于 TIME INDEX 列对数据进行分区。 因此,你无需也不建议按时间分区数据 (例如,每天一个分区或每周一个表)。
GreptimeDB 使用列式存储, 因此对表进行分区是指按行进行水平分区, 每个分区包含所有列。
何时分区以及确定分区数量
单个表能够利用机器中的所有资源,特别是在查询的时候。 分区表并不总是能提高性能:
- 分布式查询计划并不总是像本地查询计划那样高效。
- 分布式查询可能会引入网络间额外的数据传输。
因此,除非单台机器不足以服务表,否则无需分区表。 例如:
- 本地磁盘空间不足以存储数据或在使用对象存储时缓存数据。
- 你需要更多 CPU 来提高查询性能或更多内存用于高开销的查询。
- 磁盘吞吐量成为瓶颈。
- 写入速率大于单个节点的吞吐量。
GreptimeDB 在每次主要版本更新时都会发布benchmark report, 里面提供了单个分区的写入吞吐量作为参考。 你可以在你的目标场景根据该报告来估计写入量是否接近单个分区的限制。
估计分区总数时,可以考虑写入吞吐量并额外预留 50% 的 CPU 资源,以确保查询性能和稳定性。也可以根据需要调整此比例。例如,如果查询较多,那么可以预留更多 CPU 资源。
如何选择分区列
GreptimeDB 使用表达式定义分区规则。 为获得最佳性能,建议选择满足以下条件的分区列:
- 分布均匀:每个分区应接收相近比例的数据,避免单个分区成为热点。该列应有足够多的不同值来划分数据。
- 稳定:同一实体的该列值不应随时间变化。
- 与查询条件一致:该列应出现在常见查询的过滤条件中,使查询可以路由到少量分区,而不是扫描所有分区。
例如:
- 按 trace id 的前缀分区。
- 按数据中心名称分区。
- 按业务名称分区。
例如,如果大多数查询针对特定数据中心的数据,那么可以使用数据中心名称作为分区列。 如果不了解数据分布,可以对现有数据执行聚合查询以收集相关信息。
如果表不是 append-only(启用了去重),分区列必须是主键列的子集。 去重和合并只发生在单个分区内,因此具有相同主键的行必须始终路由到同一个分区。按非主键列分区会把具有相同主键的行分散到不同分区,从而破坏去重。 Append-only 表不执行去重,因此可以按任意列分区。 见数据更新和合并。
更多详情,请参考表分区指南。
SST 格式
这是一个仅与升级相关的说明;设计新表时通常不需要关注它。
GreptimeDB 默认使用 flat 格式将数据存储在 SST 文件中。它适用于所有主键基数,包括 trace_id 或 uuid 等高基数主键,因此通常不需要手动设置 sst_format 选项。
唯一需要设置 sst_format 的场景是从旧版本 GreptimeDB 升级。旧版本默认使用遗留的 primary_key 格式。如果你从这样的版本升级,或者不确定某张表当前使用哪种格式,可以将其切换为 flat:
ALTER TABLE http_logs_v2 SET 'sst_format' = 'flat';
更多详情见 SST 格式。